 Demo evaluada
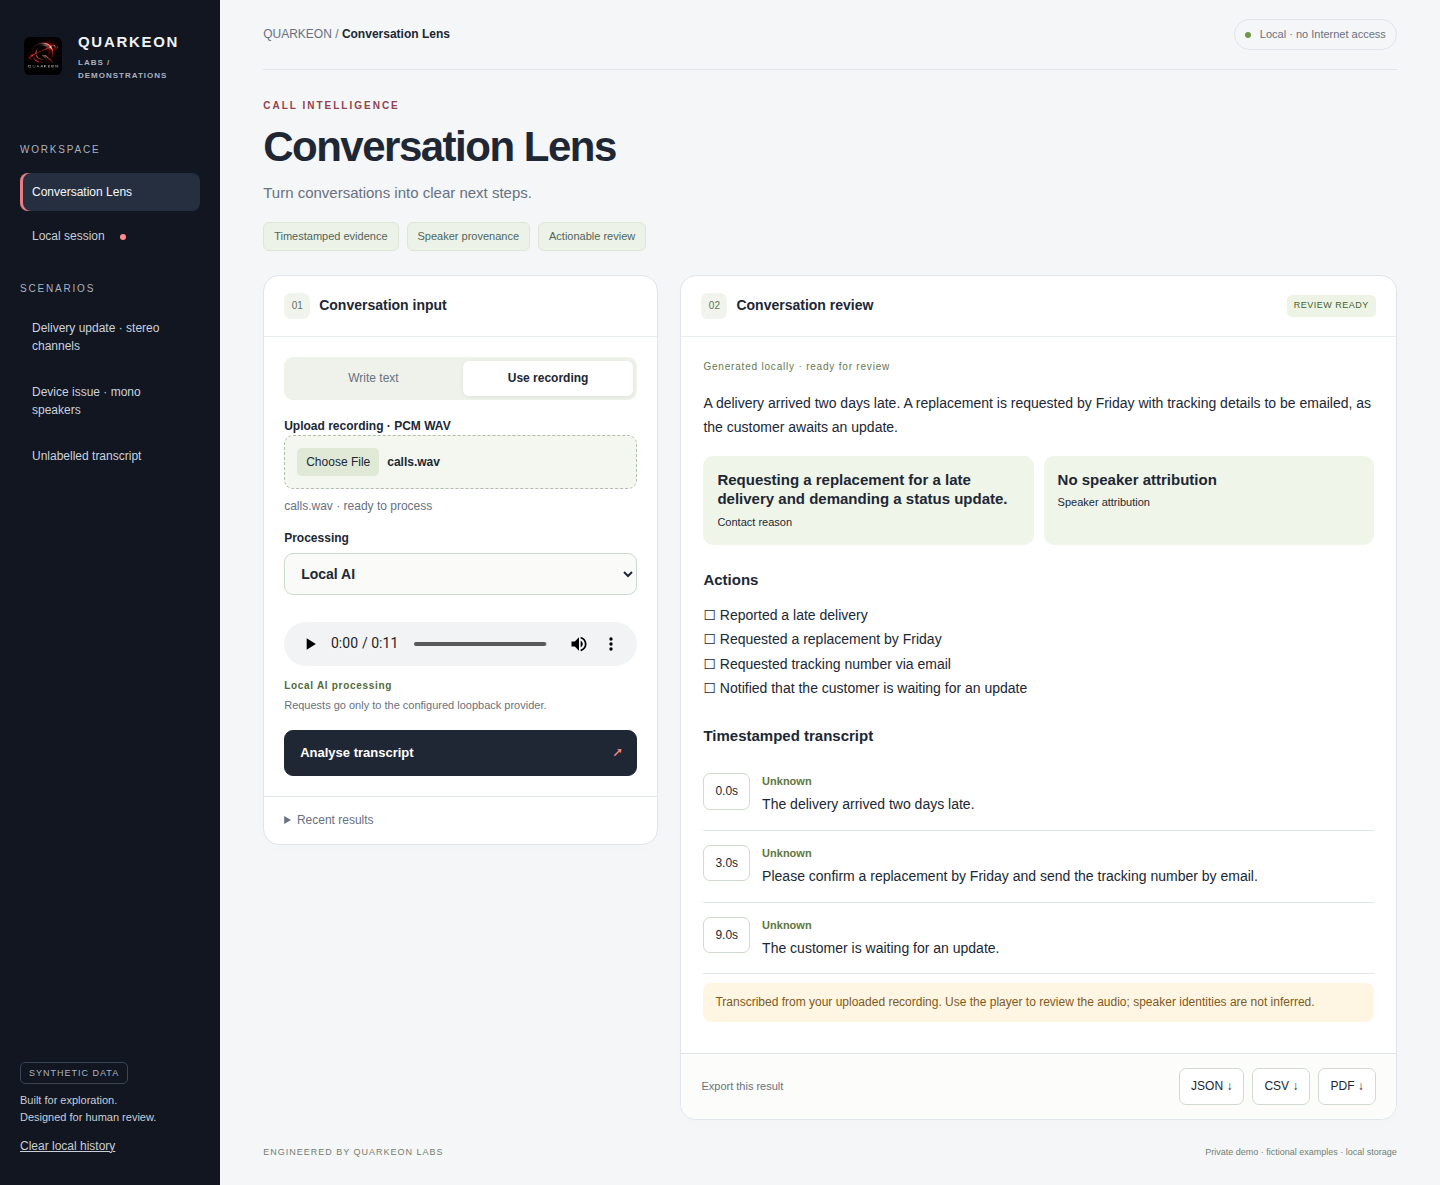
Conversation Lens
Conversaciones que se convierten en acciones.
12/12Casos con los hechos esperadosConjunto sintético registrado
Voz / Demostración evaluada
Texto que se convierte en voz controlable.
Vídeo real de la demo · Narración y subtítulos en inglés · Datos ficticios
EL PROBLEMA
EL FLUJO
Prepara texto en inglés, ajusta la voz y su velocidad, sintetiza un WAV local, escúchalo y descarga el audio.
EVIDENCIA REGISTRADA
| Comprobación | Casos |
|---|---|
| Formato PCM válido | 8/8 |
| Frecuencia de 24 kHz | 8/8 |
| Señal de audio presente | 8/8 |
Fuente: registro de evaluación del proyecto, con inferencia local. Equipo registrado: NVIDIA GeForce RTX 5060 Ti, 595.84, 16311 MiB. La latencia incluye el caso HTTP completo y puede incluir la carga inicial del modelo. Estas mediciones no se han vuelto a ejecutar en el equipo que sirve esta web.
QUÉ PODRÍAMOS CONSTRUIR CONTIGO
Licencias de voces y modelo, idiomas, pronunciación y formato de audio.
Las ocho pruebas comprueban salida PCM a 24 kHz, duración y señal. No miden calidad perceptual ni clonan voces.
Hablemos de tu caso ↗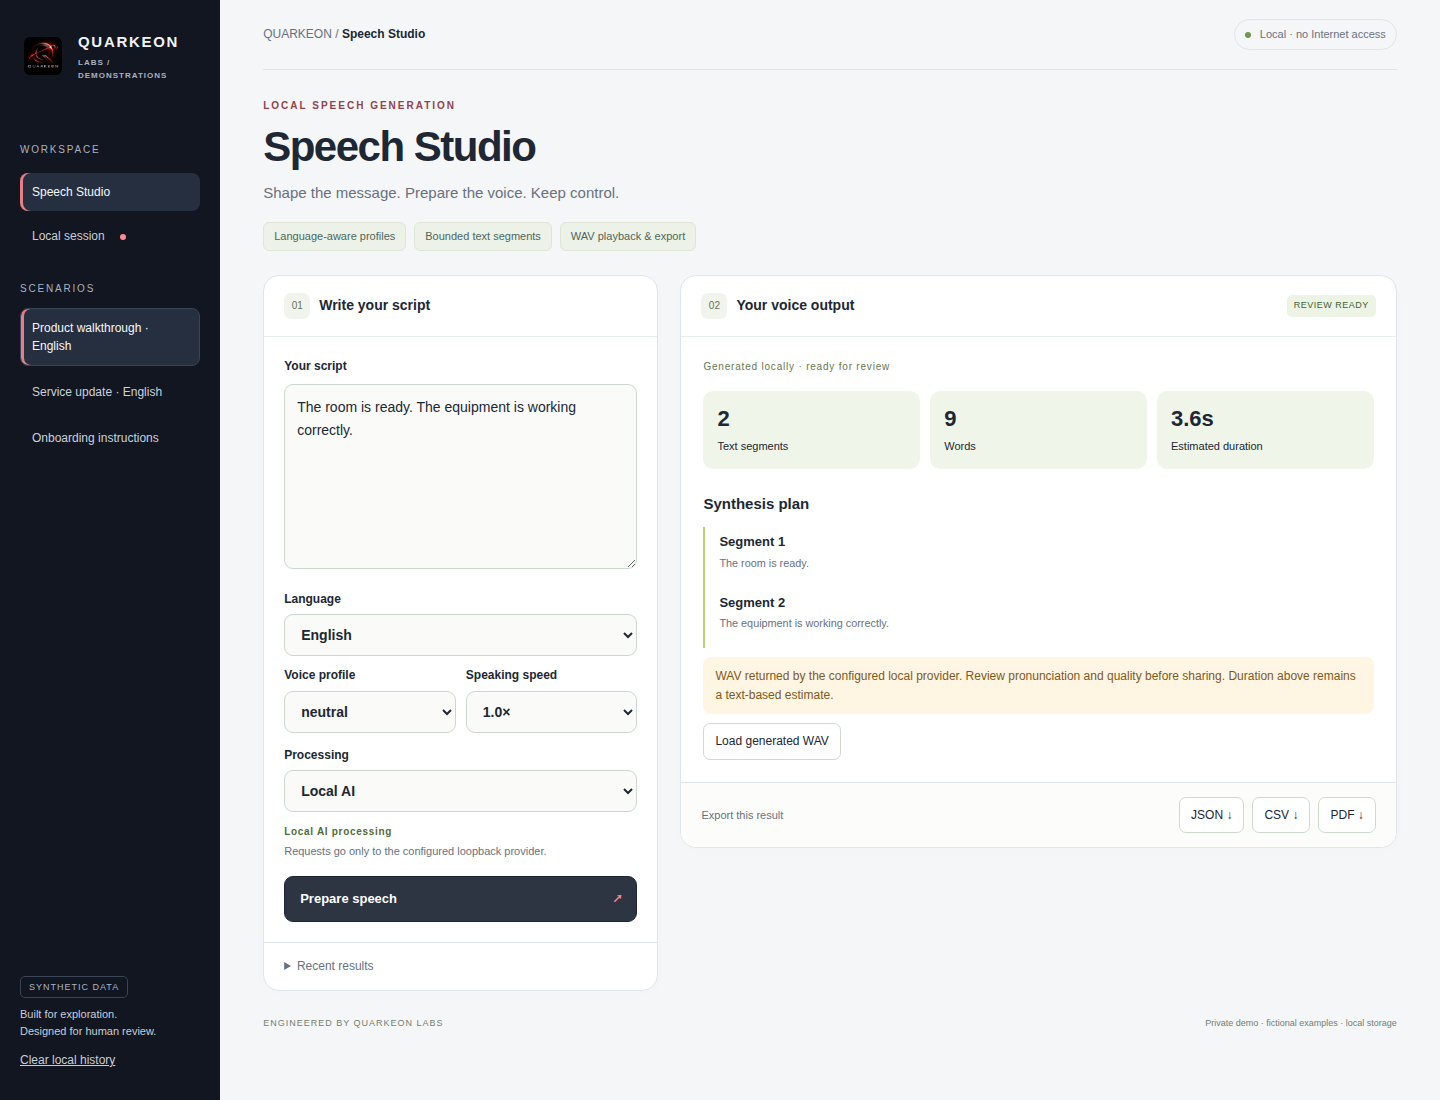 Demo evaluada
Conversaciones que se convierten en acciones.
 Demo evaluada
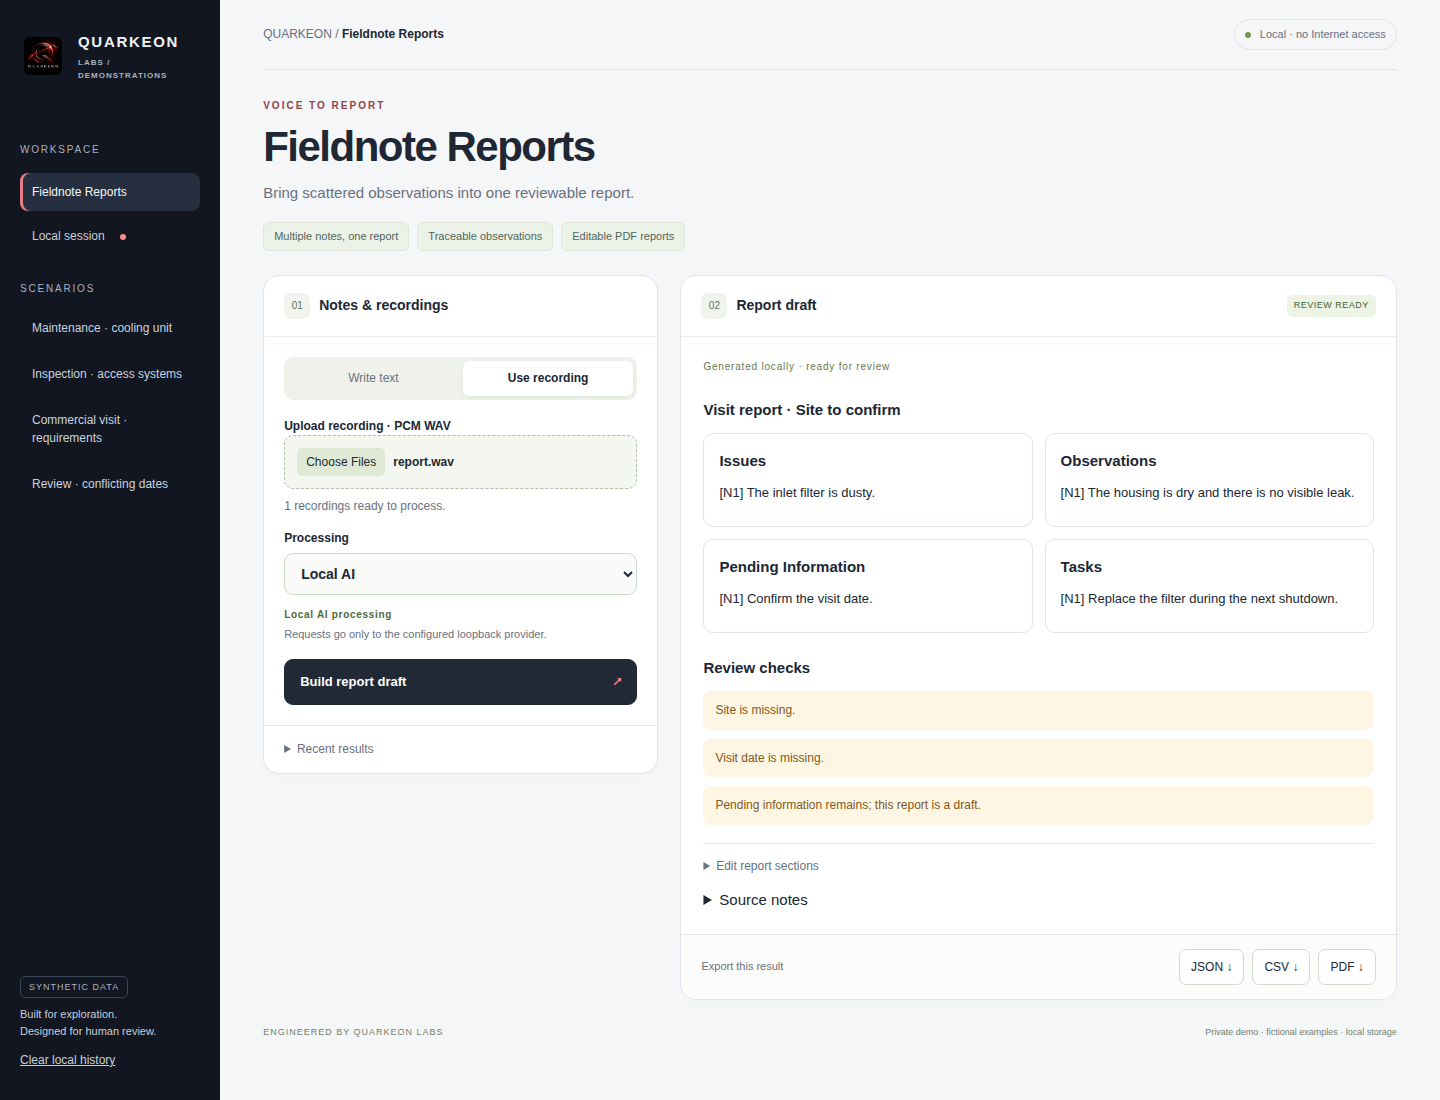
De notas dispersas a un informe revisado.